LCP de 4 segundos: como o servidor lento encarece o CPA
Como a demora do servidor (TTFB) atrasa o LCP e encarece o custo por aquisição no Meta Ads, e o que medir e corrigir no servidor, na página e na CAPI.
Por Márcio Patrick Rodrigues Dias · Publicado em · 13 min de leitura

Toda vez que alguém me manda uma mensagem dizendo que "o tráfego ficou caro", eu peço duas coisas antes de olhar qualquer campanha: a URL da página de destino e acesso ao servidor. Isso costuma irritar, porque a pessoa esperava uma conversa sobre criativo, público ou orçamento. Mas na maioria dos casos que passam pela minha mesa, o gargalo não está no gerenciador de anúncios. Está numa query sem índice rodando a cada carregamento de página.
Esse artigo é a explicação técnica dessa afirmação. Não é uma opinião sobre "sites rápidos convertem mais", frase que todo mundo repete e quase ninguém consegue justificar em números. É o caminho completo, elo por elo, entre o tempo que o seu PHP leva para devolver o primeiro byte e o valor que o Meta cobra de você por cada lead.
O leilão do Meta não vende espaço, vende previsão
Antes de falar de latência, é preciso entender o que você está comprando. Muita gente ainda opera com o modelo mental do outdoor: paguei X, apareci para Y pessoas. Não é isso.
O leilão do Meta ranqueia anunciantes por um valor total estimado que combina, de forma simplificada, três componentes: o seu lance, a taxa de ação estimada e a qualidade do anúncio. A taxa de ação estimada é a probabilidade, calculada pelo modelo, de que aquela pessoa específica execute a ação que você otimizou. Compra, lead, agendamento, o que for.
Repare no que isso implica. Você não compete apenas com o bolso de outros anunciantes. Você compete com a confiança que o modelo tem de que o seu anúncio vai converter. Dois anunciantes com o mesmo lance e o mesmo público pagam preços diferentes se o modelo achar que um deles converte melhor.
E de onde vem essa confiança? De eventos. Do histórico de conversões que o seu domínio devolveu ao Meta. Quantas, com que valor, com que consistência, com quanto atraso, e com quanto ruído.
Aqui está o ponto que quase ninguém liga: a sua infraestrutura técnica é a fábrica desses eventos. Se ela produz pouco, atrasado ou incompleto, o modelo perde precisão. Um modelo impreciso erra mais na hora de escolher para quem mostrar seu anúncio. Errar mais significa gastar impressão em gente que não compra. Gastar impressão em gente que não compra significa CPA alto.
O gerenciador vai te mostrar isso como "custo por resultado subiu". Ele não vai te dizer que o motivo é que 24% dos visitantes vindos do 4G desistiram antes do seu banner principal pintar na tela.
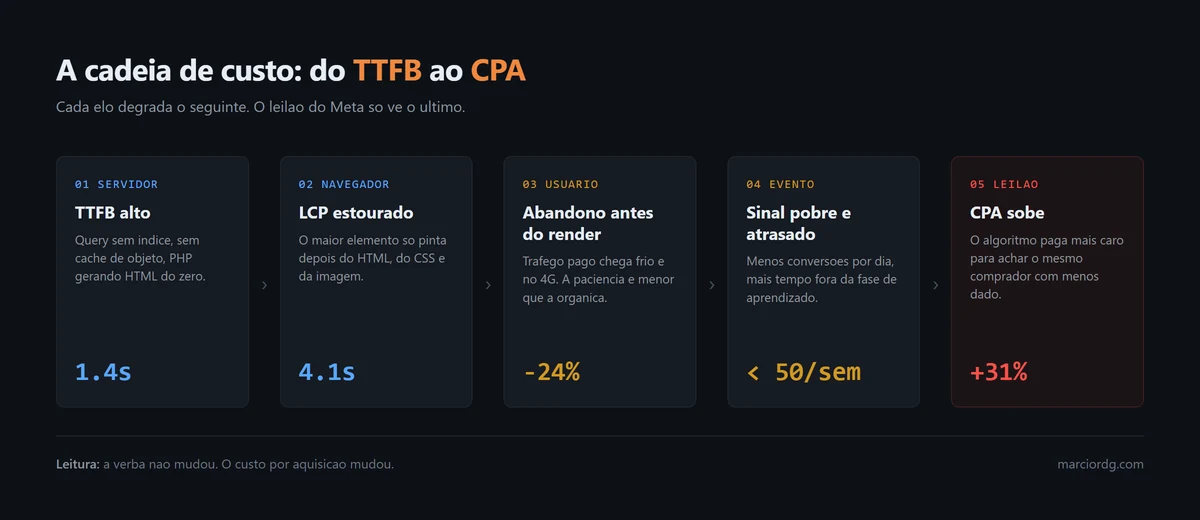
A aritmética, sem misticismo
Vamos fazer a conta. Não vou usar estudo de caso de agência, porque esses números são sempre convenientes demais. Vou usar um modelo explícito, com premissas que você pode substituir pelas suas.
Premissas do cenário:
- Verba mensal: R$ 20.000
- CPC médio: R$ 2,00, o que dá 10.000 cliques
- Taxa de conversão da landing page: 3%, ou 300 leads
- CPA resultante: R$ 66,67
Agora suponha que 20% desses cliques abandonam a página antes do conteúdo principal renderizar. Esse número não é arbitrário: o Google publica dados de bounce que crescem de forma acentuada conforme o tempo de carregamento passa de 3 segundos, e o estudo "Milliseconds Make Millions", da Deloitte com o Google em 2020, mediu ganho de 8,4% em conversão no varejo para cada 0,1 segundo de melhora no tempo de carregamento móvel. Use esses números como ordem de grandeza, não como lei da física. O comportamento real do seu público depende de intenção, oferta e dispositivo.
No modelo, 20% de abandono técnico significa que 2.000 dos seus 10.000 cliques nunca chegaram a ver a oferta. Você pagou R$ 4.000 por eles. A taxa de conversão sobre os 8.000 restantes continua sendo 3% no fundo, mas o número absoluto cai para 240 leads, e o CPA sobe para R$ 83,33.
Isso é um aumento de 25% no custo por aquisição sem que nada tenha mudado no leilão, no criativo ou no público.
E aqui a coisa piora, porque o efeito não para no primeiro nível. Com 240 conversões em vez de 300, o volume semanal de eventos cai. Se você estava próximo do limite de 50 conversões por semana por conjunto de anúncios, que é o patamar em que o Meta considera a fase de aprendizado concluída, você pode simplesmente sair dele. Conjunto travado em aprendizado tem entrega mais errática e custo menos estável. O algoritmo passa a explorar mais e explorar custa dinheiro.
Ou seja: a latência não te cobra uma vez. Ela cobra na conversão, cobra de novo na qualidade do sinal, e cobra mais uma vez na eficiência do leilão.
Onde o tempo realmente se perde
Existe uma confusão comum entre "site pesado" e "site lento". São problemas diferentes, com culpados diferentes.
O LCP, Largest Contentful Paint, mede quando o maior elemento visível da viewport termina de pintar. O limite considerado bom pelo Google é 2,5 segundos no percentil 75 dos carregamentos reais. E o LCP é uma soma, não um evento único. Ele se decompõe assim:
- TTFB. Tempo até o primeiro byte. DNS, handshake TLS, e principalmente o tempo que o seu backend leva para montar a resposta.
- Delay de carregamento do recurso. Quanto tempo passa entre o HTML chegar e o navegador descobrir que precisa daquela imagem ou fonte.
- Duração do carregamento do recurso. O download em si.
- Delay de renderização. O tempo entre o recurso estar pronto e ele efetivamente aparecer, geralmente travado por CSS ou JavaScript bloqueante.
O erro clássico é atacar só o item 3. Comprimir imagem é a otimização que todo mundo faz porque é a mais visível e a menos incômoda. Só que se o seu TTFB é 1,4 segundo, você já queimou mais da metade do orçamento de 2,5 segundos antes de o navegador ter recebido uma única letra de HTML. Nenhuma compressão de WebP conserta isso.
O TTFB é problema do backend, e quase sempre é o banco
Na esmagadora maioria dos sites que analiso, o TTFB alto tem uma de três origens: consulta sem índice, consulta em loop, ou ausência total de cache.
Vamos ao caso mais comum, o N+1. Uma landing page de catálogo que lista 30 produtos com a categoria de cada um:
<?php
// O jeito que parece inofensivo e destrói seu TTFB
$produtos = $pdo->query("SELECT id, nome, preco, categoria_id FROM produtos LIMIT 30")
                ->fetchAll(PDO::FETCH_ASSOC);

foreach ($produtos as &$produto) {
    // 30 idas ao banco. Uma por produto. Toda vez que a página carrega.
    $stmt = $pdo->prepare("SELECT nome FROM categorias WHERE id = ?");
    $stmt->execute([$produto['categoria_id']]);
    $produto['categoria'] = $stmt->fetchColumn();
}
Trinta e uma consultas. Se cada round trip ao MySQL custa 4ms, você acabou de gastar 124ms só nisso, sem contar o tempo de processamento. Numa página com três blocos desse tipo, chegamos tranquilamente a meio segundo de TTFB gerado por preguiça de escrever um JOIN.
A versão que devolve o mesmo resultado em uma consulta:
<?php
$sql = "SELECT p.id, p.nome, p.preco, c.nome AS categoria
        FROM produtos p
        INNER JOIN categorias c ON c.id = p.categoria_id
        WHERE p.ativo = 1
        ORDER BY p.destaque DESC, p.id DESC
        LIMIT 30";

$produtos = $pdo->query($sql)->fetchAll(PDO::FETCH_ASSOC);
Uma consulta. Mas cuidado com a armadilha seguinte: escrever o JOIN certo e deixar o banco sem índice apenas troca 31 consultas rápidas por 1 consulta lenta. Verifique sempre:
-- Antes de comemorar, olhe o plano de execução
EXPLAIN SELECT p.id, p.nome, p.preco, c.nome AS categoria
FROM produtos p
INNER JOIN categorias c ON c.id = p.categoria_id
WHERE p.ativo = 1
ORDER BY p.destaque DESC, p.id DESC
LIMIT 30;

-- Se aparecer "type: ALL" e "Using filesort", o banco está varrendo a tabela
-- inteira e ordenando na memória. Índice composto resolve:
CREATE INDEX idx_produtos_listagem ON produtos (ativo, destaque DESC, id DESC);
A ordem das colunas no índice composto não é decorativa. O MySQL usa o índice da esquerda para a direita, então (ativo, destaque, id) serve para filtrar por ativo e já entregar a ordenação pronta. Já (destaque, ativo, id) obrigaria uma varredura maior para aplicar o filtro. Detalhe pequeno, diferença grande no percentil 95.
Cache é o que separa TTFB de 400ms e TTFB de 40ms
Depois de arrumar as consultas, a próxima pergunta é: por que essa página está sendo montada de novo para cada visitante, se ela é idêntica para todo mundo?
Uma landing page de campanha é conteúdo estático disfarçado de conteúdo dinâmico. Ela muda quando você edita a oferta, o que acontece talvez uma vez por semana. Mesmo assim, ela é reconstruída dez mil vezes por mês porque o framework foi configurado assim e ninguém questionou.
Cache de página inteira, na versão mais simples possível, sem dependência nenhuma:
<?php
declare(strict_types=1);

/**
 * Cache de página inteira em disco.
 * Serve HTML pronto quando o arquivo é recente, regenera quando não é.
 */
final class PageCache
{
    public function __construct(
        private string $dir,
        private int $ttl = 3600
    ) {
        if (!is_dir($this->dir)) {
            mkdir($this->dir, 0775, true);
        }
    }

    private function path(string $chave): string
    {
        return $this->dir . '/' . hash('xxh3', $chave) . '.html';
    }

    public function servirSeValido(string $chave): bool
    {
        $arquivo = $this->path($chave);

        if (!is_file($arquivo) || (time() - filemtime($arquivo)) > $this->ttl) {
            return false;
        }

        header('X-Cache: HIT');
        header('Content-Type: text/html; charset=utf-8');
        readfile($arquivo);
        return true;
    }

    public function capturar(string $chave): void
    {
        header('X-Cache: MISS');
        ob_start(function (string $html) use ($chave): string {
            // Grava de forma atômica: escreve em temporário e renomeia.
            // Sem isso, uma requisição concorrente pode ler HTML pela metade.
            $arquivo = $this->path($chave);
            $temp = $arquivo . '.' . getmypid() . '.tmp';
            file_put_contents($temp, $html, LOCK_EX);
            rename($temp, $arquivo);
            return $html;
        });
    }
}

// Uso, no topo do arquivo, antes de qualquer processamento pesado
$cache = new PageCache(__DIR__ . '/../var/cache/paginas', ttl: 1800);
$chave = $_SERVER['REQUEST_URI'];

if ($cache->servirSeValido($chave)) {
    exit;
}

$cache->capturar($chave);
// A partir daqui vive o código caro: banco, API, template.
Duas decisões merecem comentário. A escrita atômica via rename existe porque rename é atômico no mesmo sistema de arquivos, então nenhum visitante concorrente vai ler um HTML truncado. E o cache é verificado antes de qualquer coisa pesada, não depois, porque cache que roda no fim do pipeline economiza banda e não economiza CPU.
Se você está atrás de Nginx, dá para subir um nível e nunca deixar a requisição chegar no PHP:
fastcgi_cache_path /var/cache/nginx levels=1:2 keys_zone=lp:100m inactive=60m max_size=1g;

server {
    location ~ \.php$ {
        fastcgi_cache lp;
        fastcgi_cache_valid 200 30m;
        fastcgi_cache_key "$scheme$request_method$host$request_uri";

        # Não sirva cache para quem tem sessão aberta
        fastcgi_cache_bypass $cookie_PHPSESSID;
        fastcgi_no_cache     $cookie_PHPSESSID;

        # Sirva conteúdo velho enquanto revalida em segundo plano.
        # O visitante nunca espera pela regeneração.
        fastcgi_cache_use_stale updating error timeout http_500 http_503;
        fastcgi_cache_background_update on;
        fastcgi_cache_lock on;

        add_header X-Cache $upstream_cache_status;
        include fastcgi_params;
        fastcgi_pass unix:/run/php/php8.3-fpm.sock;
    }
}
O par cache_use_stale updating com cache_background_update on é a parte que importa. Sem ele, quando o cache expira, o primeiro visitante azarado paga o preço da regeneração completa. Com ele, esse visitante recebe a versão anterior instantaneamente e a atualização acontece atrás dos panos. Isso derruba o percentil 95 do TTFB, que é justamente o percentil onde o dinheiro de tráfego pago costuma morrer.
O LCP no navegador: a corrida de descoberta
Com o TTFB resolvido, o problema muda de natureza. Agora não é sobre gerar o HTML rápido, é sobre o navegador descobrir rápido o que precisa baixar.
O erro mais caro nessa etapa é esconder a imagem principal do pré-carregador do navegador. O parser do Chrome faz uma varredura antecipada do HTML procurando recursos para iniciar downloads antes mesmo de o CSS terminar de processar. Se a sua imagem de destaque vive dentro de um background-image no CSS, ou é injetada por JavaScript depois da hidratação, esse pré-carregador não a enxerga. O download só começa quando o CSS ou o JS resolve, e você perdeu centenas de milissegundos de graça.
<!-- Ruim: o navegador só descobre a imagem depois de baixar e processar o CSS -->
<div class="hero" style="background-image: url('/img/hero.webp')"></div>

<!-- Bom: descoberta imediata, prioridade explícita, sem lazy no que está visível -->
<img
  src="/img/hero-800.webp"
  srcset="/img/hero-800.webp 800w, /img/hero-1600.webp 1600w"
  sizes="(max-width: 900px) 100vw, 1200px"
  width="1600" height="900"
  fetchpriority="high"
  decoding="async"
  alt="Painel de controle do sistema">
Três detalhes que carregam peso aqui:
fetchpriority="high" promove a imagem na fila de prioridade do navegador. Sem isso, o Chrome inicia imagens em prioridade baixa até concluir o layout, o que atrasa exatamente o elemento que define o seu LCP.
width e height explícitos reservam o espaço antes do download. Isso não melhora o LCP, mas evita que o layout salte quando a imagem chega, o que é o CLS. Custa dois atributos e resolve uma métrica inteira.
E o pecado mais frequente: loading="lazy" na imagem do topo. Lazy loading é excelente para o que está abaixo da dobra e é sabotagem pura para o que está acima dela. Já vi mais de uma vez um plugin de otimização aplicar lazy em tudo, indiscriminadamente, e piorar o LCP de um site em mais de um segundo enquanto exibia um selo verde de "otimizado".
Fontes seguem a mesma lógica. Uma fonte web mal configurada bloqueia o texto por centenas de milissegundos:
@font-face {
  font-family: 'Inter';
  src: url('/fonts/inter-var.woff2') format('woff2-variations');
  font-weight: 100 900;
  /* swap: mostra fallback imediatamente e troca quando a fonte chegar.
     O texto aparece rápido, ao custo de um reflow visível. */
  font-display: swap;
  /* Só baixa os glifos que o português realmente usa */
  unicode-range: U+0000-00FF, U+0131, U+0152-0153, U+2000-206F, U+2122;
}
<link rel="preload" href="/fonts/inter-var.woff2" as="font" type="font/woff2" crossorigin>O atributo crossorigin no preload de fonte não é opcional, mesmo em domínio próprio. Fontes são buscadas em modo CORS anônimo, e sem esse atributo o navegador baixa o arquivo duas vezes: uma pelo preload, outra pelo @font-face. Você paga banda dobrada para ficar mais lento. É um dos bugs de performance mais silenciosos que existem.
O sinal: por que o pixel sozinho te sabota
Digamos que você fez tudo acima. TTFB em 90ms, LCP em 1,8 segundo, conversão subiu. Ótimo. Agora existe um segundo problema, independente do primeiro, e ele é ainda menos visível: o Meta pode não estar sabendo das conversões que você teve.
O pixel client-side é um script JavaScript que roda no navegador do usuário e faz uma requisição para o domínio do Facebook. Cada uma dessas palavras é um ponto de falha. Bloqueadores de anúncio derrubam o script inteiro. O ITP do Safari limita a vida de cookies definidos por script a sete dias. O usuário fecha a aba antes do disparo completar. A conexão cai no meio.
Você não vê nada disso acontecer. O relatório simplesmente mostra menos conversões do que o seu banco de dados registrou, e todo mundo dá de ombros e chama de "divergência de atribuição".
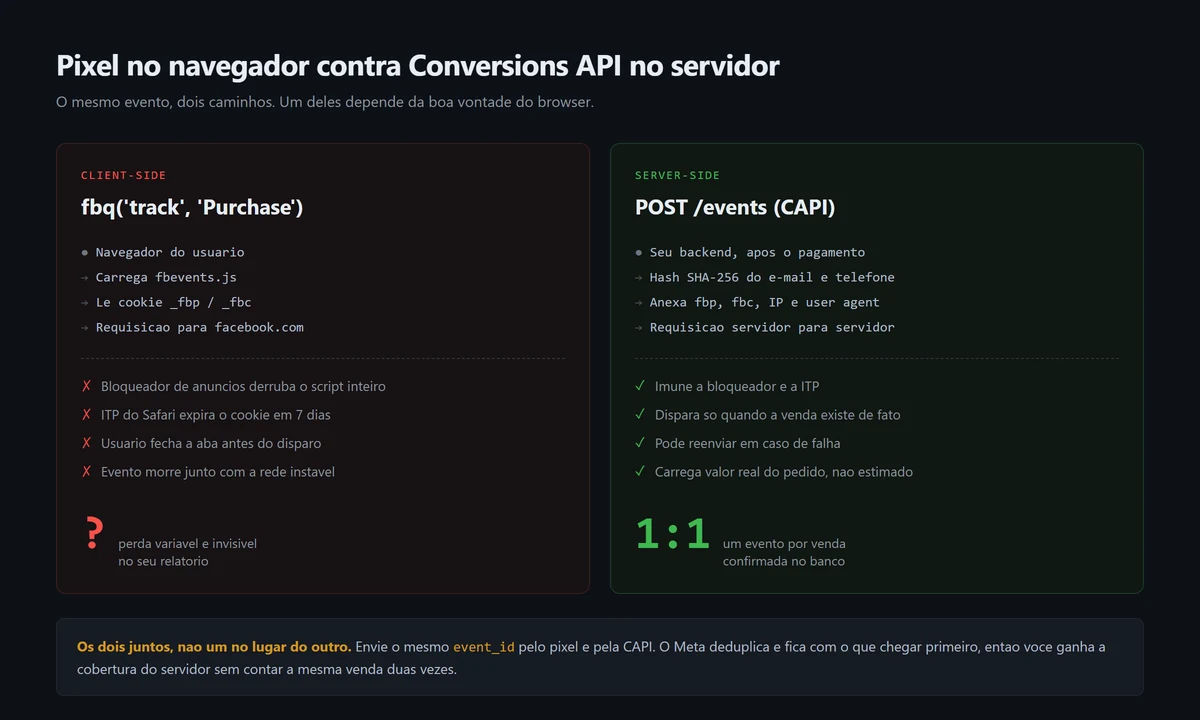
A Conversions API resolve isso mandando o evento do seu servidor direto para o Meta, depois que a venda já existe no seu banco. Não depende do navegador, não depende de cookie, não depende de o usuário ter ficado na página.
O detalhe que separa uma implementação correta de uma que infla seus números é o event_id. Se você dispara pelo pixel e pela API sem um identificador comum, o Meta conta a mesma venda duas vezes. Seu ROAS no relatório dobra, seu ROAS na conta bancária não. Com o mesmo event_id nos dois canais, o Meta deduplica e mantém o primeiro que chegar.
<?php
declare(strict_types=1);

final class MetaConversionsApi
{
    private const VERSAO = 'v21.0';

    public function __construct(
        private string $pixelId,
        private string $accessToken,
        private ?string $testEventCode = null
    ) {}

    /**
     * Normaliza e aplica hash conforme exigido pelo Meta:
     * minúsculas, sem espaços nas pontas, SHA-256 em hexadecimal.
     */
    private function hash(?string $valor): ?string
    {
        if ($valor === null || trim($valor) === '') {
            return null;
        }
        return hash('sha256', mb_strtolower(trim($valor), 'UTF-8'));
    }

    /** Telefone precisa virar E.164 sem o "+" antes do hash. */
    private function hashTelefone(?string $telefone, string $ddi = '55'): ?string
    {
        if ($telefone === null) {
            return null;
        }
        $digitos = preg_replace('/\D+/', '', $telefone) ?? '';
        if ($digitos === '') {
            return null;
        }
        if (!str_starts_with($digitos, $ddi)) {
            $digitos = $ddi . $digitos;
        }
        return hash('sha256', $digitos);
    }

    public function enviarCompra(array $pedido, array $contexto): array
    {
        $userData = array_filter([
            'em'          => $this->hash($pedido['email'] ?? null),
            'ph'          => $this->hashTelefone($pedido['telefone'] ?? null),
            'fn'          => $this->hash($pedido['primeiro_nome'] ?? null),
            'external_id' => $this->hash((string)($pedido['cliente_id'] ?? '')),
            // Estes dois NÃO recebem hash. São identificadores do próprio Meta.
            'fbp'             => $contexto['fbp'] ?? null,
            'fbc'             => $contexto['fbc'] ?? null,
            'client_ip_address' => $contexto['ip'] ?? null,
            'client_user_agent' => $contexto['user_agent'] ?? null,
        ]);

        $evento = [
            'event_name'       => 'Purchase',
            // Mesmo ID usado no fbq() do navegador. É o que evita contagem dupla.
            'event_id'         => (string) $pedido['id'],
            'event_time'       => (int) $pedido['timestamp'],
            'event_source_url' => $contexto['url'] ?? null,
            'action_source'    => 'website',
            'user_data'        => $userData,
            'custom_data'      => [
                'currency' => 'BRL',
                // Valor real do pedido pago, não o do carrinho abandonado.
                'value'    => round((float) $pedido['total'], 2),
                'contents' => array_map(
                    static fn(array $i): array => [
                        'id'         => (string) $i['sku'],
                        'quantity'   => (int) $i['qtd'],
                        'item_price' => round((float) $i['preco'], 2),
                    ],
                    $pedido['itens'] ?? []
                ),
            ],
        ];

        $payload = ['data' => [$evento], 'access_token' => $this->accessToken];
        if ($this->testEventCode !== null) {
            $payload['test_event_code'] = $this->testEventCode;
        }

        return $this->post($payload);
    }

    private function post(array $payload): array
    {
        $url = sprintf(
            'https://graph.facebook.com/%s/%s/events',
            self::VERSAO,
            $this->pixelId
        );

        $ch = curl_init($url);
        curl_setopt_array($ch, [
            CURLOPT_POST           => true,
            CURLOPT_RETURNTRANSFER => true,
            CURLOPT_HTTPHEADER     => ['Content-Type: application/json'],
            CURLOPT_POSTFIELDS     => json_encode($payload, JSON_UNESCAPED_UNICODE),
            CURLOPT_TIMEOUT        => 8,
            CURLOPT_CONNECTTIMEOUT => 3,
        ]);

        $corpo   = curl_exec($ch);
        $status  = curl_getinfo($ch, CURLINFO_HTTP_CODE);
        $erroRede = curl_error($ch);
        curl_close($ch);

        // Falha aqui é receita perdida, não um log qualquer.
        // Enfileire para retentativa em vez de engolir o erro.
        if ($corpo === false || $status >= 400) {
            throw new RuntimeException(
                "CAPI falhou (HTTP {$status}): " . ($erroRede ?: (string) $corpo)
            );
        }

        return json_decode((string) $corpo, true, 512, JSON_THROW_ON_ERROR);
    }
}
Um ponto de arquitetura que costuma ser ignorado: nunca chame a CAPI de forma síncrona dentro do fluxo de checkout. Se a API do Meta estiver lenta, você acabou de adicionar oito segundos de timeout à confirmação de compra do seu cliente. Grave o evento numa fila e processe fora do ciclo de requisição.
-- Fila mínima, sem Redis, sem broker, sem servidor novo.
CREATE TABLE eventos_capi (
  id            BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY,
  event_id      VARCHAR(64) NOT NULL,
  payload       JSON        NOT NULL,
  tentativas    TINYINT UNSIGNED NOT NULL DEFAULT 0,
  proxima_em    DATETIME    NOT NULL DEFAULT CURRENT_TIMESTAMP,
  enviado_em    DATETIME    NULL,
  ultimo_erro   TEXT        NULL,
  UNIQUE KEY uk_event (event_id),
  KEY idx_pendentes (enviado_em, proxima_em)
) ENGINE=InnoDB;
A chave única em event_id garante que uma retentativa malfeita não gere duplicata, e o índice em (enviado_em, proxima_em) faz o worker encontrar os pendentes sem varrer a tabela toda. Retentativa com espera crescente, algo como 1, 4 e 16 minutos, resolve praticamente toda instabilidade transitória.
Medir com dado real, não com laboratório
O Lighthouse é útil e é mentiroso ao mesmo tempo. Ele roda numa máquina só, com uma rede simulada, sem extensões, sem o dispositivo Android de 2019 que representa boa parte do seu tráfego de Reels. Nota 98 no Lighthouse convive tranquilamente com LCP de 4 segundos no campo.
O que importa é o dado real do usuário. E dá para coletar isso com pouco código:
// Coleta LCP e INP reais e envia junto com a origem do tráfego.
// Sem biblioteca. São 30 linhas.
(function () {
  const metricas = {};

  new PerformanceObserver((lista) => {
    const entradas = lista.getEntries();
    // O LCP pode mudar durante o carregamento. Vale a última leitura.
    metricas.lcp = Math.round(entradas[entradas.length - 1].startTime);
  }).observe({ type: 'largest-contentful-paint', buffered: true });

  new PerformanceObserver((lista) => {
    for (const entrada of lista.getEntries()) {
      const dur = Math.round(entrada.duration);
      if (dur > (metricas.inp || 0)) metricas.inp = dur;
    }
  }).observe({ type: 'event', durationThreshold: 40, buffered: true });

  const nav = performance.getEntriesByType('navigation')[0];
  if (nav) metricas.ttfb = Math.round(nav.responseStart);

  // visibilitychange é mais confiável que unload em mobile:
  // o iOS frequentemente mata a aba sem disparar unload.
  addEventListener('visibilitychange', function enviar() {
    if (document.visibilityState !== 'hidden') return;
    removeEventListener('visibilitychange', enviar);

    const params = new URLSearchParams(location.search);
    const corpo = JSON.stringify({
      ...metricas,
      url: location.pathname,
      utm_campaign: params.get('utm_campaign'),
      utm_content: params.get('utm_content'),
      conexao: navigator.connection?.effectiveType ?? null,
      memoria: navigator.deviceMemory ?? null,
    });

    // sendBeacon sobrevive ao fechamento da aba. fetch normal, não.
    navigator.sendBeacon('/api/rum', corpo);
  });
})();
Com esses dados no banco, a pergunta deixa de ser filosófica. Você consegue cruzar latência com conversão por campanha:
SELECT
  r.utm_campaign,
  COUNT(*)                                        AS sessoes,
  ROUND(AVG(r.lcp))                               AS lcp_medio_ms,
  -- A média mente. O percentil 75 é o que o Google usa e o que dói.
  ROUND(MAX(CASE WHEN r.pos = r.p75 THEN r.lcp END)) AS lcp_p75_ms,
  ROUND(100 * SUM(r.converteu) / COUNT(*), 2)     AS taxa_conversao_pct
FROM (
  SELECT
    m.*,
    ROW_NUMBER() OVER (PARTITION BY m.utm_campaign ORDER BY m.lcp)          AS pos,
    CEIL(0.75 * COUNT(*) OVER (PARTITION BY m.utm_campaign))                AS p75
  FROM rum_metricas m
  WHERE m.criado_em >= NOW() - INTERVAL 30 DAY
) r
GROUP BY r.utm_campaign
HAVING sessoes >= 500
ORDER BY lcp_p75_ms DESC;
Rode isso uma vez e a conversa com o gestor de tráfego muda de tom. Em vez de discutir se o criativo está saturado, você tem uma tabela mostrando que a campanha com LCP de 4,3 segundos no percentil 75 converte metade da campanha que carrega em 1,9. Mesmo público, mesma oferta, servidor diferente.
Vale um aviso sobre causalidade, porque isso é onde análises assim costumam descarrilar. Correlação entre LCP alto e conversão baixa pode ter uma terceira causa: talvez a campanha lenta traga usuários de rede pior, e usuários de rede pior tenham menos poder aquisitivo. O jeito honesto de fechar a questão é segmentar por effectiveType da conexão e comparar dentro do mesmo estrato, ou melhor, fazer um teste A/B real com duas versões da mesma página em velocidades diferentes. Sem isso, você tem uma hipótese forte, não uma prova.
O que isso significa na prática
A separação entre "time de tecnologia" e "time de marketing" é uma conveniência organizacional que o leilão do Meta não respeita. O modelo de machine learning que decide o seu custo por lead não sabe que o backend é responsabilidade de um fornecedor e a campanha é de outro. Ele só vê eventos: quantos chegaram, quando, com que valor, com que consistência.
Um índice faltando no MySQL é uma decisão de mídia. Um loading="lazy" colado na imagem do topo é uma decisão de mídia. Um pixel disparando sem event_id compartilhado com a CAPI é uma decisão de mídia, e das caras. Essas linhas de código são reguladores de custo que ninguém no time comercial sabe que existem, ajustados por gente que nunca abriu o gerenciador de anúncios.
Não é que performance técnica seja mais importante que criativo ou oferta. É que ela vem antes deles na ordem de execução. Um criativo excelente que leva o usuário para uma página que demora 4 segundos está comprando atenção para depois jogá-la fora, e você paga pelos dois lados dessa transação: paga o clique e paga a piora do modelo que decide o próximo clique.
O bom sinal de que essa engrenagem está funcionando não é uma nota verde em ferramenta de auditoria. É o momento em que o número de conversões no seu banco de dados e o número no gerenciador de anúncios param de divergir sem explicação. A partir daí você está finalmente otimizando a campanha, e não compensando com verba um problema que era de código.
Quem escreveu
- Márcio Patrick Rodrigues DiasSócio e responsável técnico
Leia também
- Tráfego e dadosPor que o pixel perde conversões e como resolver
- Tráfego e dadosMeta CAPI para clínicas: como medir lead de verdade
- Performance e sitesDomínio, hospedagem, site e rastreamento: de quem é cada um